CASE STUDY / SYSTEMS & OPERATIONS
Kubernetes Observability
In meiner IT-Praxis bei interSales ging es darum, Zustände eines Kubernetes-Clusters in einer Testumgebung so sichtbar zu machen, dass Fehlerbilder eingegrenzt werden können.
Betriebliche Testumgebung
Alle drei Projekte ansehen ↗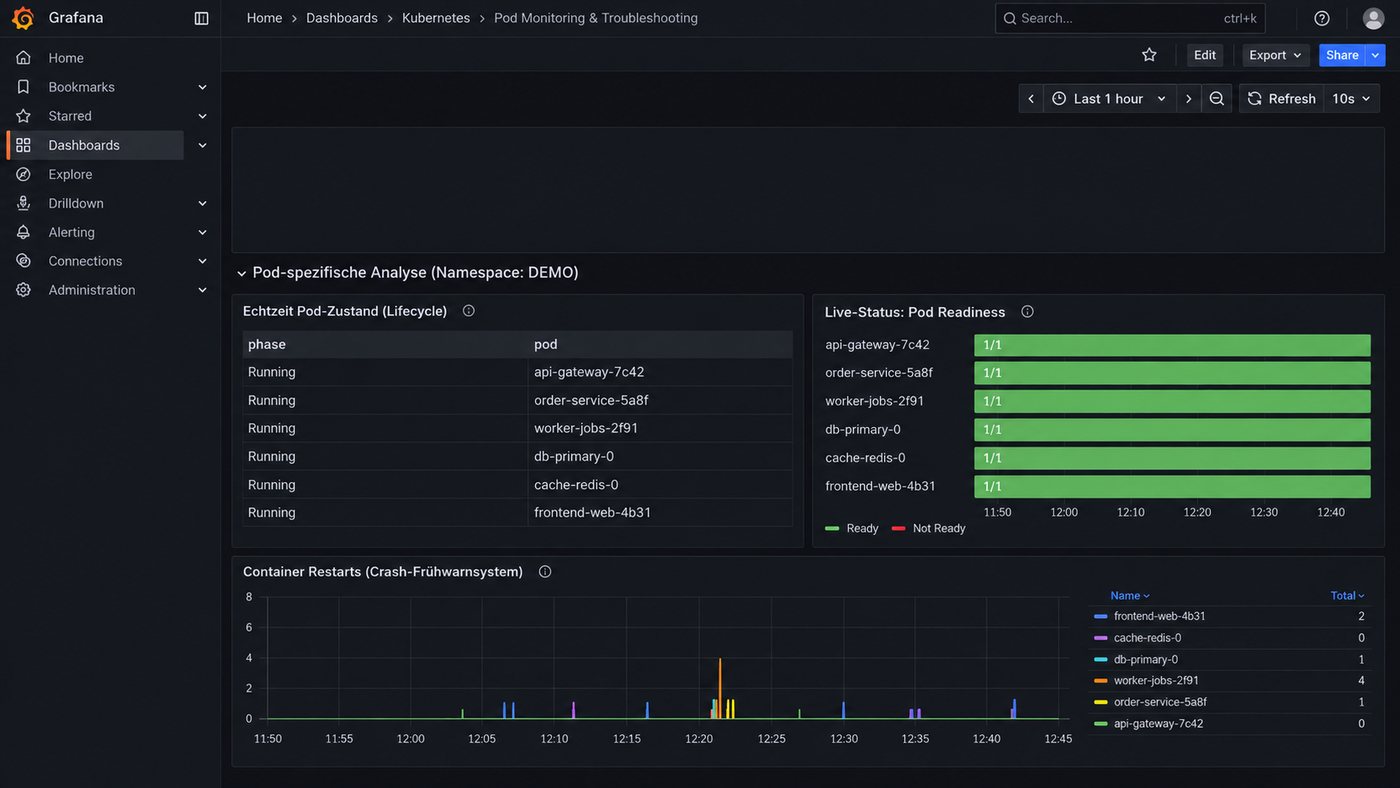
01 / AUSGANGSLAGE & ZIEL
Das konkrete Problem.
Ein einzelnes Signal erklärt einen gestörten Workload nicht. Für die Einordnung sollten Pod-Zustände, Readiness und Neustarts gemeinsam lesbar sein.
02 / ROLLE & ARCHITEKTUR
Mein Beitrag und die Bausteine.
Ich habe die Monitoring-Umgebung in der Testumgebung mit Alloy, Prometheus und Grafana aufgebaut und dokumentiert.
- Kubernetes-Testcluster
- Grafana Alloy
- Prometheus
- Grafana-Dashboard
03 / ENTSCHEIDUNG & LÖSUNG
Was ich bewusst geändert oder aufgebaut habe.
Die relevanten Cluster-Signale wurden in einer gemeinsamen Ansicht zusammengeführt. So lassen sich Readiness und Neustarts neben dem Pod-Zustand betrachten.
04 / ERGEBNIS & GRENZE
Was heute belegt ist.
Ein echtes Dashboard aus der Testumgebung ist als Bild belegt. Ein produktiver Unternehmenscluster oder eine behobene Produktionsstörung wird hier nicht behauptet.
05 / LESSONS LEARNED
Was ich daraus mitnehme.
Monitoring wird nützlicher, wenn es eine konkrete Diagnosefrage beantwortet. Der nächste Schritt für eine stärkere Case Study wären dokumentierte Beispielvorfälle und überprüfbare Vorher/Nachher-Daten.
06 / ORIGINALBELEGE